더게이트
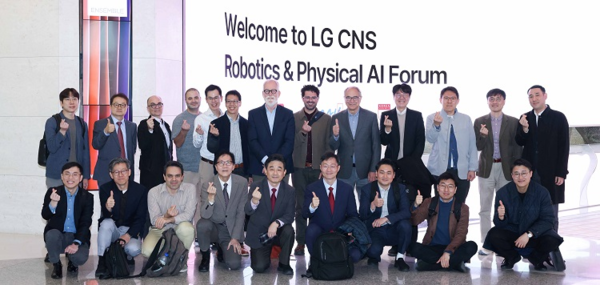
“로봇 프로젝트 1천건 경험 꺼냈다”…LG CNS, 석학들과 피지컬 AI 산업화 논의
더게이트
 (사진=신한은행 제공)
[더게이트]
신한은행이 은행 업무에 적합한 대규모 언어모델(LLM)을 선별하고 인공지능(AI) 에이전트의 답변부터 실제 업무 수행 과정까지 검증하는 금융 특화 AI 평가체계를 국제 학술무대에 공개했다.
신한은행은 지난 15일(현지시간) 이탈리아 밀라노에서 열린 글로벌 인공지능 학술대회 ‘ICAIF(International Conference on AI in Finance) 2026’ 워크숍에서 금융 AI의 안전성과 신뢰성을 높이기 위한 연구 논문 2편을 발표했다고 16일 밝혔다.
ICAIF는 금융과 인공지능 기술의 융합을 주제로 최신 연구 성과와 산업 적용 사례를 공유하는 국제 학술대회다.
신한은행이 발표한 연구는 은행 업무용 LLM 평가 벤치마크 프레임워크 ‘K-BankEval’과 내부 AI 에이전트 평가·검증 플랫폼 ‘Agent Foundry’를 활용한 업무 수행 검증 기술이다.
K-BankEval은 여신·수신·외환 등 은행 업무 전반의 특성을 반영해 총 5000개 문항과 6개 평가 영역으로 구성했다.
평가 영역은 은행 업무 전문지식, 금융 문서 검색 및 근거 기반 답변(RAG), 업무에 필요한 도구 호출, 은행 업무 관련 계산·추론, 금융소비자 보호 관점의 응답 안전성, AI 에이전트의 업무 수행 계획 등이다.
신한은행이 6개 LLM을 비교 평가한 결과 범용 AI 성능이 우수한 모델도 실제 은행 업무에서는 영역별 수행 능력에 차이가 나타났다. 이를 통해 업무 특성에 맞는 모델을 선정하고 각 LLM의 취약점을 진단할 수 있는 평가 기반을 마련했다.
“정답 맞혔는지만 보지 않는다”…AI가 일하는 과정까지 들여다본다 신한은행 본점 (사진=더게이트 DB)
‘Agent Foundry’는 은행 업무에 활용할 AI 에이전트의 최종 답변뿐 아니라 업무를 수행하는 과정까지 함께 검증하는 내부 평가 플랫폼이다.
업무 요구사항을 검증 사례와 평가 기준으로 구체화한 뒤 AI 에이전트의 답변과 도구 실행 기록을 분석해 업무 기준 충족 여부와 필요한 도구를 적절하게 사용했는지, 업무 실행 과정이 효율적인지 등을 점검한다.
신한은행은 이를 통해 AI 에이전트를 실제 업무에 적용하기 전에 기준을 충족한 영역과 추가 보완이 필요한 부분을 체계적으로 확인할 수 있도록 했다.
이번 연구에서는 업무별 필수 확인 사항과 실제 실행 기록을 연계해 검증하는 방식과 판단 근거가 충분하지 않은 사례를 정상적인 통과 사례와 구분하는 방법 등 평가체계의 개선 방향도 제시했다.
신한은행은 향후 이 같은 평가·검증 체계를 AI 기반 업무 처리의 정확성과 안정성을 높이는 데 활용할 계획이다.
신한은행 관계자는 “금융 분야에서 AI를 활용하기 위해서는 높은 성능뿐 아니라 실제 업무에 적합한지, 업무 수행 과정이 기준에 맞게 이뤄지는지를 함께 검증하는 것이 중요하다”며 “앞으로도 금융 환경에 특화된 AI 평가·검증 기술을 고도화해 고객과 직원이 안심하고 활용할 수 있는 금융 AI 환경을 만들어가겠다”고 말했다.

Hi, I’m Greg – Product Designer
{page_url}


Notion


More

Screenshot

Long
Screenshot

Copy link

Send to your
devices

QR code


관심 없음
{카테고리}에 관심 없음